Callbots & IA vocale entrepriseMis à jour le 17 min de lecture
Latence d'un callbot : un critère décisif et sa mesure
Les éditeurs de callbots annoncent souvent des latences flatteuses, rarement mesurées dans les mêmes conditions ni sur le même périmètre : un temps de synthèse vocale seul n'est pas une latence d'appel. Ce guide fait le point sur les repères publiés, montre où les millisecondes s'accumulent dans le pipeline vocal, et détaille une méthode reproductible pour mesurer cette latence sur vos propres appels plutôt que de croire une fiche produit.
Photo : kaboompics.com · Pexels
Corrigé le 22/10/2026 : la première version de cet article (23/09/2026) présentait comme établis, sans source, des seuils de 700 à 800 ms et de 1 à 1,5 s, qui sont des repères avancés par des éditeurs, utilisait la recommandation UIT-T G.114 et l'étude de Stivers et al. hors de leur périmètre, et affichait comme publiée une ligne « Réseau » du tableau de Twilio que nous avions calculée nous-mêmes. Elle affirmait aussi, à tort, que la somme des horodatages des journaux techniques donnait la même latence qu'un chronométrage sur l'enregistrement de l'appel. Ces points sont corrigés ci-dessous. Plusieurs autres affirmations sans source ont aussi été retirées ou nuancées, dont l'idée qu'un callbot sortant disposerait d'une marge de latence plus large. Notre politique de corrections.
Un callbot peut avoir la voix la plus naturelle du marché et un moteur de langage capable de comprendre n'importe quelle reformulation : si sa réponse tarde, c'est ce silence que l'appelant perçoit en premier. La latence est le premier critère qu'un appelant juge, avant même d'avoir écouté le contenu de la réponse — et un critère sur lequel les éditeurs communiquent souvent de façon imprécise : la plupart de leurs chiffres mesurent une portion de l'appel plus étroite que ce qu'entend l'appelant, ou ne disent pas où le chronomètre démarre et s'arrête. Ce guide fait le point sur les repères publiés, détaille où les millisecondes s'accumulent dans le pipeline vocal, et propose une méthode pour mesurer cette latence sur vos propres appels plutôt que sur une fiche technique.
Ce que l'oreille humaine tolère
En conversation humaine, le délai moyen entre la fin d'une question fermée, qui appelle un oui ou un non, et le début de la réponse est de 208 millisecondes, selon une étude menée sur dix langues — Stivers et al., 2009 —, avec des écarts d'une langue à l'autre que les auteurs qualifient de mineurs (moyennes de 7 millisecondes en japonais à 469 en danois, à environ 250 millisecondes au plus de la moyenne générale) ; les auteurs y voient un indicateur raisonnable de la prise de parole en général. Ce n'est pas une cible technique réaliste — un interlocuteur humain anticipe la fin de la phrase pour préparer sa réponse, et dans le test sur de vrais appels d'Openbenchmarks relayé par Telnyx, aucune des cinq plateformes mesurées n'avait de médiane inférieure à une seconde côté appelant — mais un point de repère, qui explique pourquoi un délai supplémentaire se remarque, même chez un appelant incapable de le chiffrer.
Pour un callbot, le repère le plus souvent avancé — autour de 700 à 800 millisecondes — vient d'éditeurs, qui ne citent pas d'étude à l'appui : Retell situe vers 700 millisecondes la limite au-delà de laquelle la conversation cesse de paraître humaine, AssemblyAI vers 800 millisecondes. D'autres placent la barre plus bas : selon Vapi, les utilisateurs remarquent un délai vers 300 millisecondes. La téléphonie a ses propres repères, qui portent sur la transmission de la voix et non sur le temps de réponse d'un interlocuteur : la recommandation UIT-T G.114, d'application volontaire, indique qu'en dessous de 150 millisecondes de délai de transmission dans un sens, de bouche à oreille, la plupart des applications gardent une interactivité pratiquement transparente, et juge inacceptable pour la planification générale des réseaux un délai dans un sens supérieur à 400 millisecondes. Un callbot ajoute son propre traitement à ce délai de transmission, que la voix subit à l'aller puis au retour.
Au-delà de leur propre seuil, Retell et AssemblyAI décrivent des appelants qui parlent par-dessus l'agent, se répètent ou raccrochent ; selon Telnyx, vers deux secondes de silence, l'appelant croit la ligne coupée et se remet à parler, par-dessus la réponse de l'agent. Les seuils cités ici vont de 300 millisecondes à deux secondes, selon l'éditeur et selon l'effet décrit.
Où naît la latence dans le pipeline
« La latence d'un callbot » n'est jamais un seul chiffre : c'est la somme de plusieurs maillons qui s'enchaînent — ou se chevauchent, sur les architectures récentes — entre le silence de l'appelant et le premier son audible de la réponse. Twilio publie ses propres repères (novembre 2025) : des valeurs médianes de départ pour le premier lancement d'un agent en cascade simple, et non le meilleur niveau atteignable, données de bout en bout et pour chaque étage :
| Étage | Cible visée | Limite haute |
|---|---|---|
| Réseau : trajet de la voix entre l'appelant et la plateforme, aller et retour, avec décodage, encodage et mémoires tampons (écart entre les deux totaux de Twilio, voir la note) | 230 ms | 300 ms |
| Reconnaissance vocale (STT) | 350 ms | 500 ms |
| Modèle de langage, premier jeton | 375 ms | 750 ms |
| Synthèse vocale, premier octet audio | 100 ms | 250 ms |
| Total côté plateforme, hors réseau | 885 ms | 1 100 ms |
| Total bouche-à-oreille | 1 115 ms | 1 400 ms |
Twilio publie les deux totaux et les trois étages dans ses tableaux ; la ligne « Réseau » est l'écart entre ses deux totaux (1 115 − 885 ms sur la cible, 1 400 − 1 100 ms en limite haute). Sur la cible, le graphique détaillé de Twilio décompose ces 230 ms en 120 ms de transmission (de l'appareil de l'appelant au point d'entrée du réseau, puis au serveur d'orchestration, à l'aller comme au retour) et 110 ms de décodage, d'encodage et de mémoires tampons ; la limite haute de 300 ms n'y est pas détaillée, c'est un calcul de la rédaction. Toujours sur la cible, le total côté plateforme dépasse de 60 ms la somme des trois étages (885 contre 825 ms) : Twilio attribue ces 60 ms à l'orchestration, six passages de 10 ms entre le serveur d'orchestration et les services de reconnaissance vocale, de modèle de langage et de synthèse vocale. Les limites hautes ne s'additionnent pas : celles des trois étages totalisent déjà 1 500 ms, plus que la limite haute de bout en bout.
Deux maillons comptent parmi les plus variables d'un appel à l'autre. Le premier est invisible dans ce tableau : à l'intérieur de la reconnaissance vocale se cache la détection de fin de tour (endpointing), la décision que l'appelant a fini de parler. Un minuteur trop court coupe la parole à qui hésite ; trop long, il ajoute des centaines de millisecondes inutiles — Cekura résume le dilemme : une pause de 400 millisecondes paraît déjà poussive au téléphone, une seconde complète paraît franchement cassée. Deepgram propose une détection anticipée, qui laisse le modèle réfléchir avant la fin officielle du tour : un gain de 100 à 200 millisecondes, payé par 50 à 70 % d'appels supplémentaires au modèle — dont une partie sera jetée si l'appelant n'avait pas terminé.
Le second maillon caché est l'un de ceux que les fiches produit omettent souvent : le trajet téléphonique lui-même. Un test mené par TECHSY du 6 au 8 juin 2026, relayé par Telnyx — 120 appels sortants par opérateur depuis une même région de l'est des États-Unis, Telnyx y obtenant le trajet le plus rapide —, mesure sur le seul trajet opérateur, en aller-retour, des latences de 71 à 94 millisecondes en médiane selon l'opérateur, et jusqu'à 161 millisecondes au 95ᵉ centile ; la ligne « Réseau » du tableau ci-dessus, déduite des totaux de Twilio, couvre tout le trajet de la voix entre l'appelant et la plateforme ainsi que, sur la cible, 110 ms de décodage, d'encodage et de mémoires tampons ; les deux chiffres, issus de mesures différentes, ne se comparent pas directement. Un modèle de synthèse vocale annoncé à 75 millisecondes mesure ainsi, selon ElevenLabs, le seul calcul du modèle, avant d'y ajouter le réseau (20 à 200 ms) et la mise en mémoire tampon du lecteur audio (500 ms est courant). Un chiffre qui ne précise ni le périmètre mesuré ni la présence d'une vraie ligne téléphonique ne se compare à rien — le même problème de méthode que nous détaillons pour les taux de résolution dans comment choisir un callbot.
Mesurer la latence réelle d'un appel
Un chiffre obtenu en démonstration commerciale ne dit presque rien : la démonstration tourne sur un réseau propre, sans concurrence d'autres appels, avec un scénario déjà rodé. Seule une mesure sur de vrais appels, dans vos conditions, compte. Voici une méthode reproductible, sans outillage spécialisé.
Enregistrer des appels réels, pas une démonstration. Demandez l'export de l'enregistrement audio complet (.wav ou .mp3) d'une série d'appels réellement passés par des appelants — vérifiez auprès de la plateforme ou de l'opérateur que cet export est possible, et de quel côté de l'appel il est enregistré.
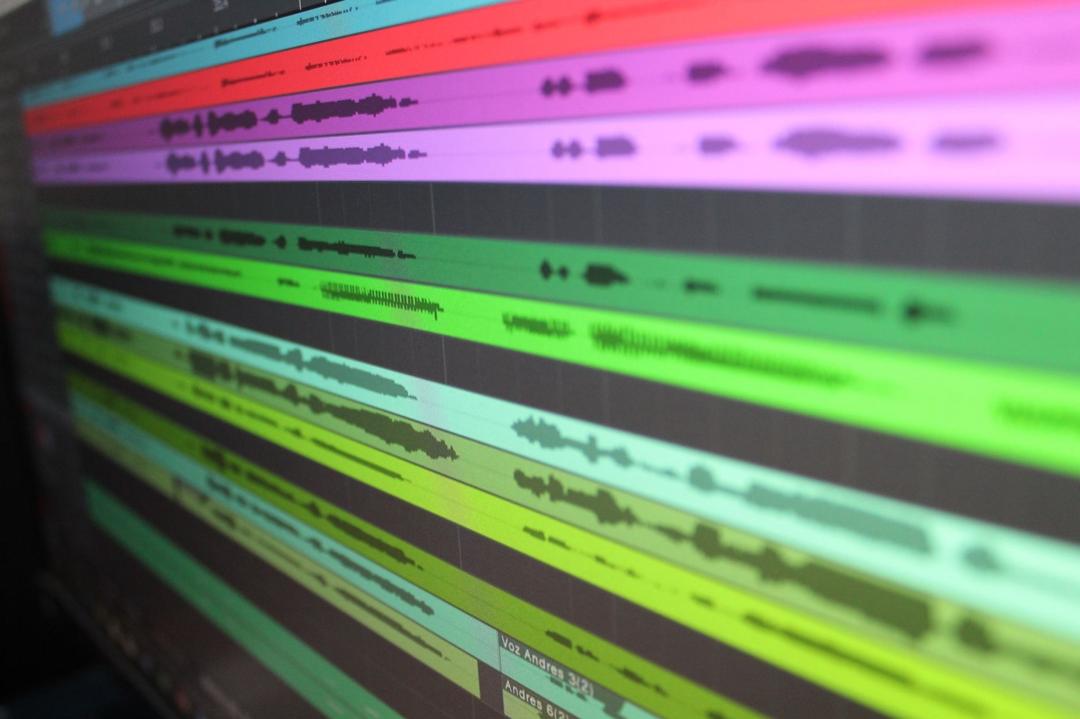
Chronométrer précisément, sur chaque tour de parole. Ouvrez l'enregistrement dans un éditeur audio gratuit affichant la forme d'onde, et repérez, pour chaque tour de l'appel (pas seulement le premier, parfois artificiellement plus rapide ou plus lent), l'instant où la voix de l'appelant s'arrête et celui où le premier son du callbot commence : cet écart approche la latence bouche-à-oreille, la seule qui compte pour l'appelant, à condition que l'enregistrement soit fait côté appelant ; enregistré côté plateforme, il ne compte pas le trajet de la voix entre l'appelant et la plateforme.
Répéter sur un échantillon d'appels, pas un seul. Une vingtaine d'appels distincts, à des heures différentes, donne un premier ordre de grandeur ; à titre de comparaison, les tests relayés par Telnyx portent sur environ 430 tours de parole par plateforme (Openbenchmarks) et 120 appels par opérateur (TECHSY).
Retenir une médiane et une valeur haute, pas une moyenne isolée. Classez les mesures et relevez la médiane ainsi qu'une valeur haute (la plus lente sur dix, une approximation du 90ᵉ centile) — le principe déjà détaillé dans notre grille de critères de choix d'un callbot : un outil à 400 ms en moyenne mais avec des pics à deux secondes peut paraître moins fluide qu'un outil régulier à 500 ms (chiffres donnés à titre d'illustration), car, écrit AssemblyAI, les humains se calent sur un rythme et sont bien plus gênés par la variance que par le délai absolu.
Tester en conditions dégradées. Reprenez une partie de l'échantillon depuis un mobile en zone de couverture moyenne, avec du bruit de fond réel, et si possible pendant un pic de simultanéité d'appels : un outil mesuré à 500 ms en test isolé peut dériver nettement dès que plusieurs appels se chevauchent sur la même ligne.
Recommencer périodiquement. Un changement de modèle, une bascule d'infrastructure ou une mise à jour de consignes côté éditeur peuvent faire dériver la latence sans alerte visible. Une mesure faite une seule fois avant signature ne garantit rien douze mois plus tard.
Avec accès aux journaux techniques d'un intégrateur, une mesure complémentaire se fait par points d'ancrage plutôt qu'à l'oreille — méthode détaillée par AssemblyAI : horodatage de fin de tour, du premier jeton du modèle, du premier octet audio en sortie. Ces écarts indiquent à quel étage la latence se construit, mais leur somme ne remplace pas le chronomètre : elle s'arrête au premier son produit par la plateforme et ne compte pas le trajet de la voix entre l'appelant et la plateforme. Dans le test d'Openbenchmarks relayé par Telnyx, la latence déclarée par les plateformes pour les mêmes appels était inférieure d'environ 490 millisecondes à celle mesurée côté appelant.
Leviers de réduction
Une fois la latence mesurée et le maillon fautif identifié, plusieurs leviers existent — la plupart ont une contrepartie : coût de calcul, risque d'erreur, ou qualité perçue ailleurs.
| Levier | Gain typique documenté | Contrepartie |
|---|---|---|
| Détection de fin de tour anticipée (eager end-of-turn) | 100 à 200 ms | 50 à 70 % d'appels supplémentaires au modèle de langage |
| Diffusion des jetons du modèle en flux, sans attendre la réponse complète | 100 à 300 ms | orchestration technique plus complexe |
| Codec téléphonique unique de bout en bout | 100 à 300 ms | suppose une infrastructure télécom modernisée |
| Hébergement rapproché et réutilisation de connexion | 40 à 100 ms | disponibilité régionale du fournisseur |
| Voix pré-chargée, phrases fréquentes en cache | 100 à 200 ms | ne fonctionne que sur des réponses répétitives |
| Appels annexes (CRM, agenda) rendus asynchrones | 50 à 200 ms | complexité de développement supplémentaire |
Sources : gains annoncés par Vapi (juin 2025) et Deepgram, sans protocole de mesure publié. La colonne « Contrepartie » est une appréciation de la rédaction, sauf la hausse des appels au modèle, chiffrée par Deepgram.
Le choix et l'hébergement du modèle de langage pèsent au moins autant que ces réglages : le temps avant le premier jeton varie de plusieurs centaines de millisecondes d'un modèle à l'autre, et le classement Artificial Analysis relayé par MarkTechPost fin août 2026 montre qu'un même modèle répond plus vite ou plus lentement selon l'hébergeur choisi, indépendamment de ses paramètres — un sujet suivi dans notre pilier IA & modèles.
L'architecture compte enfin davantage que chaque réglage isolé : Retell décrit l'écart entre un pipeline séquentiel, qui attend la fin complète de chaque étage, et un pipeline en flux, où transcription, génération et synthèse démarrent dès que les premiers éléments sont prêts — l'écart se compte en secondes, pas en dixièmes de seconde.
Arbitrages qualité/latence/coût
La plupart de ces leviers ne sont pas des gains purs : ils déplacent le curseur ailleurs, et le bon réglage dépend du cas d'usage.
Une détection de fin de tour trop agressive gagne des millisecondes mais coupe la parole aux appelants qui marquent une pause pour réfléchir ou épeler un nom. Un modèle plus rapide est souvent plus petit, donc moins capable sur une reformulation complexe : le gain de vitesse peut se traduire par davantage de transferts vers un humain, annulant une partie du bénéfice perçu. Une infrastructure optimisée pour la vitesse — codec unique, hébergement dédié — peut coûter plus cher à intégrer qu'une configuration générique, détaillé dans les coûts cachés d'un projet callbot.
Le sens de l'appel change aussi le contexte : un callbot entrant répond à un appelant qui a pris l'initiative d'appeler, un callbot sortant compose lui-même le numéro ; la même méthode de mesure s'applique aux deux.
Un service client à fort volume, sur des demandes simples, peut raisonnablement privilégier la vitesse brute, quitte à perdre quelques points de précision sur les cas rares. Un scénario réglementé ou à fort enjeu — santé, finance, réclamation sensible — peut au contraire accepter un délai un peu plus long en échange d'un modèle plus capable et d'une détection de fin de tour plus prudente.
Questions fréquentes
Quelle latence faut-il viser pour qu'un callbot paraisse naturel ?
Pour un callbot, les repères publiés viennent d'éditeurs, qui ne citent pas d'étude à l'appui, et ne concordent pas : le plus souvent avancé se situe autour de 700 à 800 millisecondes entre la fin de la phrase de l'appelant et le début de la réponse (Retell, AssemblyAI), d'autres placent la barre plus bas (300 millisecondes chez Vapi, 400 chez Cekura). Au-delà d'une seconde, plusieurs éditeurs décrivent une rupture nette ; vers deux secondes, selon Telnyx, l'appelant croit la ligne coupée. La moyenne seule ne suffit pas : un outil à 400 ms en moyenne mais avec des pics à deux secondes peut paraître moins fluide qu'un outil régulier à 500 ms (chiffres donnés à titre d'illustration), car, écrit AssemblyAI, les humains sont bien plus gênés par la variance que par le délai absolu.
Pourquoi la latence annoncée par un éditeur ne correspond-elle pas à ce que j'entends en appel réel ?
Parce que le chiffre publié mesure le plus souvent une portion de l'appel plus étroite que ce qu'entend l'appelant — un modèle de synthèse vocale seul, ou un délai relevé côté plateforme, sans le réseau téléphonique — ou ne dit pas où le chronomètre démarre et s'arrête ; dans le test d'Openbenchmarks relayé par Telnyx, la latence déclarée par les plateformes pour les mêmes appels était inférieure d'environ 490 millisecondes à celle mesurée côté appelant. Chaque maillon supplémentaire ajoute des dizaines à des centaines de millisecondes que la fiche produit ne montre pas, et un chiffre sans périmètre ni conditions de test précisés n'est comparable à rien.
Combien d'appels faut-il mesurer pour obtenir un chiffre fiable ?
Une vingtaine d'appels distincts, répartis sur plusieurs créneaux horaires, donne un premier ordre de grandeur pour repérer un outil qui affiche une bonne moyenne mais des pics fréquents ; les tests publiés relayés par Telnyx portent sur environ 430 tours de parole par plateforme (Openbenchmarks) et 120 appels par opérateur (TECHSY). Mesurez chaque tour de parole de chaque appel, pas seulement le premier échange, et retenez la valeur haute plutôt que la seule moyenne.
Une latence plus faible signifie-t-elle toujours une meilleure expérience ?
Non. Une détection de fin de tour trop agressive gagne des millisecondes mais coupe la parole aux appelants qui hésitent ; un modèle plus rapide est parfois moins capable sur les demandes complexes, ce qui peut augmenter les transferts vers un humain et annuler une partie du gain perçu. La latence reste un critère décisif, mais elle se pondère avec la précision des réponses et le coût de l'infrastructure qui la permet.
En résumé
La latence d'un callbot se juge à l'aune de trois repères : environ 200 millisecondes entre une question fermée et sa réponse dans une conversation humaine, 700 à 800 millisecondes pour le seuil le plus souvent avancé par les éditeurs, qui ne citent pas d'étude à l'appui, et au-delà d'une seconde pour la rupture que plusieurs d'entre eux décrivent. Elle se construit sur plusieurs maillons — réseau, détection de fin de tour, reconnaissance vocale, modèle de langage, synthèse vocale, transport téléphonique — que les chiffres publiés par les éditeurs décrivent rarement dans leur ensemble. La seule façon de savoir ce que vos appelants vivront réellement est de la mesurer vous-même, sur des appels réels, en échantillon suffisant et en conditions dégradées, puis de répéter la mesure dans le temps plutôt qu'une seule fois avant signature. Si vous voulez appliquer cette méthode à votre projet, parlons-en.
Sources
- Universals and cultural variation in turn-taking in conversation — consulté le 21/10/2026
- How Real-Time Voice AI Actually Works (STT → LLM → TTS, Explained) — consulté le 21/10/2026
- How to build the lowest latency voice agent in Vapi: Achieving ~465ms end-to-end Latency — consulté le 21/10/2026
- Speech Latency Solutions: Complete Guide to Sub-500ms Voice AI — consulté le 21/10/2026
- G.114 : Temps de transmission dans un sens — consulté le 21/10/2026
- Voice AI Agents Compared on Latency: 2026 Benchmarks — consulté le 21/10/2026
- A Guide to Core Latency in AI Voice Agents (Cascaded Edition) — consulté le 21/10/2026
- What Is Endpointing in Voice AI? A Guide to Turn Detection — consulté le 21/10/2026
- Optimize Voice Agent Latency with Eager End of Turn — consulté le 21/10/2026
- Understanding latency — consulté le 21/10/2026
- Lowest-Latency Inference APIs for Voice and Realtime Agents: A Time to First Token TTFT-First Benchmark — consulté le 21/10/2026